Digitale Souveränität ist für Unternehmen eine strategische Frage: Wer kontrolliert Daten, Technologien und Betriebsmodelle? Und wie schnell kann eine Organisation handeln, wenn sich die Rahmenbedingungen ändern? Gleichzeitig kursieren rund um das Thema zahlreiche Vereinfachungen. Auf dem Prüfstand daher: sechs verbreitete Annahmen.
Muss souveräne IT im eigenen Rechenzentrum laufen? Gregor von Jagow von Red Hat prüft sechs Annahmen zu Cloud, Open Source und souveräner KI.
(Bild: Red Hat)
Laut einer Untersuchung von Red Hat hat digitale Souveränität für 80 Prozent der befragten IT-Verantwortlichen in Deutschland höchste Priorität. Doch nicht alles, was rund um das Thema im Umlauf ist, stimmt.
1. „Digitale Souveränität bedeutet: Die gesamte IT muss im eigenen Rechenzentrum laufen.“
Faktencheck: Falsch.
Digitale Souveränität ist keine Frage des Besitzes von Hardware, sondern der Handlungsfähigkeit. Ein Unternehmen muss selbst entscheiden können, wo ein Workload betrieben wird, welche Daten wohin fließen, wer darauf zugreifen darf und wie sich eine Anwendung bei veränderten Anforderungen auf eine andere Infrastruktur verlagern lässt. Damit kann auch eine Cloud Teil einer souveränen IT-Architektur sein. Entscheidend sind unter anderem Portabilität, Interoperabilität, standardisierte Schnittstellen und die Möglichkeit, Betriebsmodelle zu wechseln. Eine hybride Architektur kann beispielsweise sensible Workloads auf eigener oder speziell abgesicherter Infrastruktur betreiben, während weniger kritische Anwendungen skalierbare Cloud-Ressourcen nutzen. Die Systeme sollten möglichst wenig von proprietären Diensten einer einzelnen Plattform abhängig sein. Container, Kubernetes-basierte Plattformen und offene APIs können dabei helfen, Workloads zwischen unterschiedlichen Umgebungen beweglich zu halten. Souveränität bedeutet also nicht „alles selbst zu betreiben“, sondern eine Alternative zu haben. Wer wechseln kann, hat eine andere Verhandlungsposition als ein Unternehmen, dessen Anwendungen, Datenformate und Betriebsprozesse untrennbar an einen Anbieter gekoppelt sind.
2. „Unsere Daten liegen in Deutschland, also sind sie souverän.“
Faktencheck: Datenresidenz allein reicht nicht.
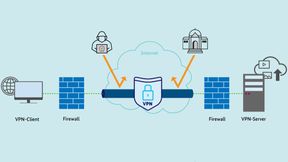
Wo Daten gespeichert werden, ist relevant, beantwortet aber nur einen Teil der Frage. Ebenso wichtig sind die Fragen, wer auf die Daten zugreifen kann, wer die Schlüssel kontrolliert, welche Software sie verarbeitet und wer den Betrieb administriert. Ein Rechenzentrum kann physisch in Deutschland stehen, während die eingesetzte Software, zentrale Managementsysteme oder Supportstrukturen von einem ausländischen Anbieter kontrolliert werden. Damit ist die tatsächliche Zugriffskontrolle noch nicht geklärt. Souveräne Datenverarbeitung erfordert deshalb ein mehrschichtiges Sicherheitsmodell. Dazu gehören etwa Identity and Access Management, konsequente Privilegienkontrolle, Auditierbarkeit und Verschlüsselung. Relevant sind dabei alle drei Zustände von Daten: Data at Rest, Data in Transit und Data in Use. Für den Schutz während der Verarbeitung können beispielsweise Technologien wie Confidential Computing eingesetzt werden. Besonders wichtig ist das Schlüsselmanagement: Wer die kryptografischen Schlüssel kontrolliert, verfügt über eine wesentlich stärkere technische Kontrolle als ein Unternehmen, das diese vollständig an einen externen Dienstleister delegiert.
Faktencheck: Open Source ist weder automatisch sicher noch unsicher.
Der entscheidende Unterschied liegt in der Kontroll- und Überprüfbarkeit. Bei quelloffener Software kann der Code grundsätzlich unabhängig analysiert, auf Schwachstellen untersucht und an die eigenen Anforderungen angepasst werden. Das reduziert insbesondere die Abhängigkeit davon, was ein einzelner Hersteller über Funktionsweise und Weiterentwicklung seiner Software offenlegt. Für digitale Souveränität ist zudem die Substituierbarkeit wichtig. Wenn eine Anwendung auf offenen Standards und dokumentierten Schnittstellen basiert, lässt sich eine einzelne Komponente eher austauschen, ohne die gesamte Architektur neu aufbauen zu müssen. Das ist gerade bei kritischen Plattformen relevant. Proprietäre Abhängigkeiten können beispielsweise entstehen, wenn Datenformate, APIs oder Managementfunktionen nicht portierbar sind. Open Source kann hier eine Grundlage schaffen, auf der unterschiedliche Anbieter Dienstleistungen erbringen können. Allerdings ist Quelloffenheit kein Freifahrtschein. Unternehmen müssen auch bei Open-Source-Software Lieferketten, Abhängigkeiten, Patch-Prozesse und Governance kontrollieren.
4. „Cloud und digitale Souveränität schließen sich aus.“
Faktencheck: Das Problem ist nicht die Cloud, sondern fehlende Kontrolle.
Cloud Computing kann bestehende Abhängigkeiten verstärken, muss es aber nicht. Ausschlaggebend ist, wie Anwendungen und Daten an die jeweilige Umgebung gekoppelt sind. Eine Lösung, die zentrale proprietäre Datenbanken, Storage-Dienste, Identitätsmechanismen und spezifische Cloud-APIs nutzt, lässt sich nur mit erheblichem Aufwand migrieren. Die technische Abhängigkeit wird damit zur strategischen Abhängigkeit. Anders sieht es bei einer Architektur aus, die containerisiert, API-basiert und auf offenen Standards aufgebaut ist. Sie kann Workloads grundsätzlich in unterschiedlichen Umgebungen betreiben, vom eigenen Rechenzentrum über einen lokalen Provider bis zur Public Cloud. Es geht nicht darum, jede Anwendung jederzeit verschieben zu können. Eine solche Fähigkeit zur „Cloud-Flucht“ wäre wirtschaftlich und technisch oft nicht sinnvoll. Entscheidend ist vielmehr, kritische Abhängigkeiten bewusst zu kennen und Wechselmöglichkeiten für relevante Workloads vorzusehen. Für KI-Anwendungen gewinnt diese Frage zusätzlich an Bedeutung. Training, Inferenz und Datenverarbeitung stellen unterschiedliche Anforderungen an Rechenleistung, Kosten, Latenz und Datenschutz. Eine souveräne Architektur kann deshalb skalierbare Ressourcen für bestimmte Trainingsaufgaben nutzen und sensible Inferenz-Workloads in einer kontrollierten Umgebung betreiben.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
5. „Souveräne KI setzt die Entwicklung eines eigenen Sprachmodells voraus.“
Faktencheck: Der Neubau eines Foundation Models ist nicht erforderlich.
Ein eigenes Large Language Model von Grund auf zu trainieren, ist für die meisten Unternehmen weder technisch noch wirtschaftlich sinnvoll. Für souveräne KI kommt es eher darauf an, wer Modell, Daten, Inferenz und Betrieb kontrolliert. Unternehmen können etwa Open-Weight-Modelle einsetzen und diese in einer eigenen oder kontrollierten Infrastruktur betreiben. Dadurch lässt sich die Inferenz so gestalten, dass sensible Prompts und Unternehmensdaten nicht an eine externe Modell-API übertragen werden müssen. Auch die Spezialisierung eines bestehenden Modells kann wesentlich effizienter sein als ein komplettes Neutraining. Je nach Anwendungsfall kommen dafür unter anderem Retrieval-Augmented Generation, Fine-Tuning, synthetische Daten oder kontrollierte Wissenseinspeisung infrage. Auf der Infrastrukturseite geht es wiederum um mehr als nur das Modell. Komponenten für Model Serving und Inferenz wie vLLM oder llm-d können dazu beitragen, Modelle effizient und skalierbar in der eigenen Umgebung bereitzustellen.
6. „Digitale Souveränität kann man einfach einkaufen.“
Faktencheck: Technologie allein macht noch keine souveräne Organisation.
Selbst die souveränste Plattform hilft wenig, wenn niemand weiß, welche Abhängigkeiten in der eigenen IT bestehen. Digitale Souveränität ist deshalb auch eine Frage der Architekturkompetenz und Governance. Unternehmen müssen zunächst Transparenz schaffen: Welche Anwendungen und Dienste werden eingesetzt? Wo werden Daten gespeichert und verarbeitet? Welche externen Abhängigkeiten bestehen? Welche Komponenten sind geschäftskritisch? Wie schnell lässt sich ein Anbieter wechseln, und welche Daten, Schnittstellen oder Skills wären dafür erforderlich? Daraus folgt eine zentrale Anforderung an die IT-Architektur: Die Exit-Fähigkeit muss bereits bei der Planung berücksichtigt werden. Dazu gehören dokumentierte Schnittstellen, portable Datenformate, reproduzierbare Deployments, getestete Backup- und Recovery-Verfahren sowie Know-how im eigenen Unternehmen. Das bedeutet nicht, dass proprietäre Technologien grundsätzlich ausgeschlossen werden müssen. Ein Unternehmen kann sich bewusst für eine solche Lösung entscheiden, wenn deren Vorteile die entstehenden Abhängigkeiten rechtfertigen. Souverän ist diese Entscheidung aber erst dann, wenn die Konsequenzen bekannt sind und Alternativen zumindest bewertet wurden.
Fazit: Souverän ist nicht, wer alles selbst macht
Digitale Souveränität lässt sich nicht auf einen Rechenzentrumsstandort, eine Cloud-Strategie oder den Einsatz von Open Source reduzieren. Sie entsteht aus dem Zusammenspiel von Daten, Technologie, Betrieb und Governance. Im Kern geht es um die Fähigkeit eines Unternehmens, Kontrolle und Handlungsfreiheit auch dann zu bewahren, wenn sich ein Anbieter, regulatorische Anforderungen, die Bedrohungslage oder die eigenen Geschäftsanforderungen verändern. Dazu gehören Transparenz über technologische Abhängigkeiten, belastbare Alternativen und die technische Fähigkeit, diese bei Bedarf auch umzusetzen.